La frase «ejecuta tu propia novia IA» hace pensar en un solo programa. En la práctica son tres piezas que se hablan entre sí, y entender qué hace cada una ahorra casi toda la frustración.
Las tres piezas
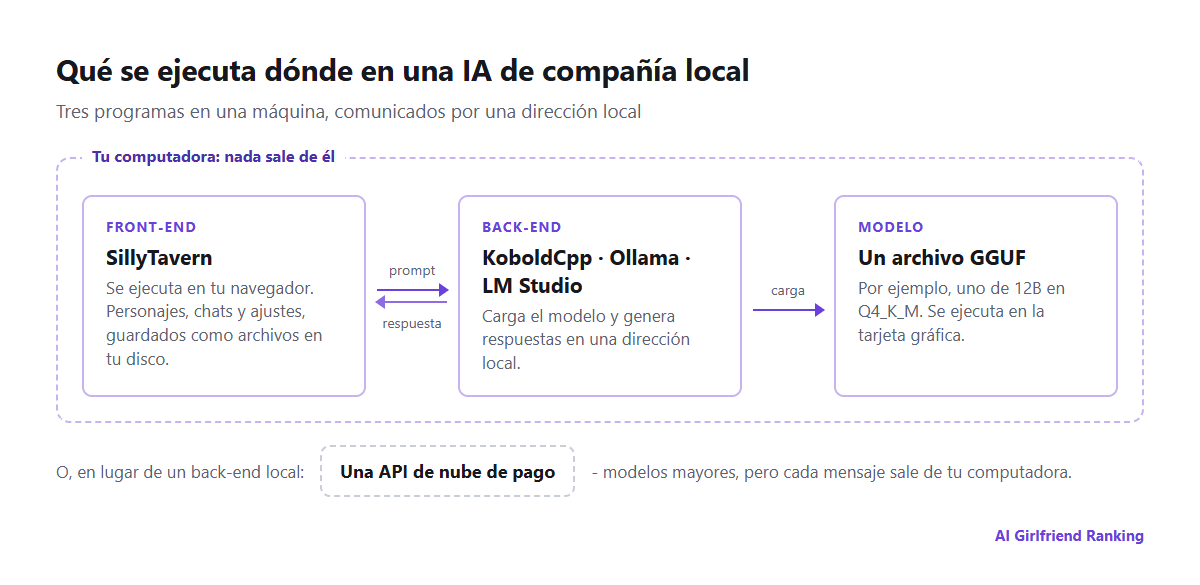
Qué se comunica con qué en una instalación local típica.
La interfaz (front-end) es lo que ves: ventanas de chat, personajes, avatares, ajustes. SillyTavern es la opción estándar para el chat con personajes. Funciona en tu navegador, guarda personajes y chats como archivos en tu disco y se conecta a casi cualquier back-end. No genera texto por sí misma.
El back-end carga el modelo y genera las respuestas. KoboldCpp es un único programa que no necesita instalación y es popular para el rol porque expone todos los ajustes de generación. Ollama es la forma más fácil de poner un modelo en marcha con unos pocos comandos. LM Studio es una aplicación de escritorio con un explorador de modelos cómodo. Cualquiera de ellos sirve el modelo en una dirección local a la que se conecta la interfaz.
El modelo es un archivo grande, normalmente en formato GGUF, que se descarga de Hugging Face. Su tamaño en parámetros (8B, 12B, 24B) y su cuantización deciden lo bueno que es y el hardware que necesita.
La cuestión del hardware
Lo que decide si un modelo funciona bien es la memoria gráfica (VRAM). El modelo tiene que caber, más espacio para la propia conversación. La cuantización reduce los modelos para que quepan: «Q4_K_M» es el compromiso habitual entre tamaño y calidad.
| Tamaño del modelo | Memoria aprox. en Q4 | Hardware típico | Qué esperar |
|---|---|---|---|
| 7-8B | 5-6 GB | Tarjeta gráfica de 8 GB | Coherente y rápido, pierde detalles en escenas largas |
| 12-14B | 9-10 GB | Tarjeta de 12 GB | Personajes y prosa claramente mejores |
| 22-24B | 14-16 GB | Tarjeta de 16-24 GB | Cerca de las buenas apps alojadas para rol |
| 70B | 40 GB o más | Dos tarjetas o un Mac con mucha memoria | Excelente, lento y caro |
Estas cifras son aproximadas: un contexto más largo necesita más memoria encima. Los Mac con Apple Silicon comparten la memoria entre procesador y gráficos, así que un MacBook de 32 GB puede ejecutar modelos que una tarjeta gráfica de 12 GB no. Un modelo que no cabe se desborda al procesador principal y se arrastra: si las respuestas llegan a unas pocas palabras por segundo, baja a un modelo más pequeño antes de probar una cuantización más dura. Un modelo más pequeño con buena calidad suele ganar a uno mayor exprimido demasiado.
Lo que ganas
- Una privacidad que no depende de una política. Nada sale de la máquina. Sin plazo de conservación, sin entrenamiento, sin acceso del personal, nada que eliminar después.
- Ningún filtro más allá del propio modelo. Tú eliges el modelo, incluidos los afinados específicamente para rol. El suelo legal sobre el contenido te sigue aplicando, pero ningún operador añade reglas por encima.
- Sin suscripción ni créditos. Genera todo lo que quieras.
- Personajes que son tuyos. Las tarjetas de personaje son imágenes PNG normales con la ficha del personaje incrustada. Se mueven entre interfaces y una actualización no puede quitártelas.
- Estabilidad. Un modelo que funciona hoy funcionará igual dentro de cinco años. Nadie puede cambiártelo por debajo, el riesgo descrito en cuando tu IA de compañía cambia de la noche a la mañana.
Lo que sacrificas
- Tiempo de configuración. Cuenta con una tarde para el primer chat que funcione y con semanas de trasteo si te gusta.
- La memoria es cosa tuya. Las apps alojadas resumen y guardan datos sobre ti sin que lo notes. En local lo gestionas con los lorebooks, los resúmenes y las notas de personaje de SillyTavern, los mismos tres mecanismos que se explican en cómo funciona la memoria de una IA de compañía, pero con los controles a la vista.
- Imágenes y voz son proyectos aparte. Generar imágenes necesita su propio modelo y normalmente más memoria gráfica; la voz necesita herramientas de reconocimiento y de síntesis de voz. Todo es posible, nada es automático.
- El celular es incómodo. Puedes abrir la interfaz desde el celular con el wifi de casa. Usarla fuera de casa implica exponer tu computadora a internet, y eso exige cuidado.
- Techo de calidad. Los mejores modelos alojados son más grandes que cualquiera que la mayoría pueda ejecutar en casa, sobre todo en coherencia a largo plazo.
La vía intermedia y su pega
Mucha gente ejecuta SillyTavern en su propia máquina pero la conecta a una API de nube de pago en lugar de a un modelo local. Obtienes el control de la interfaz y los archivos de personaje, modelos mucho más grandes y un precio por mensaje que puede ser barato para un uso ligero.
Pero no es privado. Cada mensaje va al proveedor de la API, bajo sus normas de registro, conservación y contenido, a menudo más estrictas con el rol que las de las apps de compañía especializadas. Es otro equilibrio, no una instalación local.
Lo básico de seguridad
- Descarga el software solo desde las páginas oficiales del proyecto en GitHub o desde la web del propio proyecto.
- Descarga los modelos de usuarios conocidos de Hugging Face y prefiere archivos GGUF, que contienen datos del modelo y no código.
- Lee la licencia del modelo. Algunas restringen el uso comercial; unas pocas restringen cierto contenido.
- Mantén SillyTavern limitada a tu propia máquina o red doméstica, salvo que hayas puesto una contraseña y entiendas lo que expones.
SillyTavern se desarrolla abiertamente en GitHub.
Para quién es
Ejecuta una compañera en local si la privacidad es tu principal preocupación, ya tienes hardware potente o disfrutas configurando tanto como usando. Quédate con una app alojada si quieres voz, imágenes y memoria larga funcionando desde el primer momento, o si chateas sobre todo en el celular. Nuestra guía para elegir una primera app cubre ese camino. Mucha gente acaba con las dos: una app alojada por comodidad y una instalación local para las conversaciones que preferiría no guardar en ningún otro sitio.